벤치마크가 다가 아니야! vLLM으로 보는 LLM 추론 최적화
Ollama x FriendliAI Seoul Meetup에 다녀와서
들어가며
AI 모델의 성능이라고 하면 어떤 게 가장 먼저 떠오르나요? 저는 새 모델이 발표될 때마다 함께 공개되는 여러 벤치마크 점수가 가장 먼저 생각납니다. 그런데 이번에 Ollama x FriendliAI Seoul Meetup에 다녀오면서, AI 모델을 서빙하는 입장에서는 이 점수뿐 아니라 응답 속도나 동시에 처리할 수 있는 요청 수, 비용 같은 추론(inference) 성능도 굉장히 중요하다는 걸 알게 됐습니다.
모델을 직접 띄워 본 경험은 Ollama나 LM Studio로 Gemma 정도를 돌려 본 게 전부였습니다. 그마저도 메모리가 부족해서 제대로 쓰기 어려웠고, 혼자 쓰다 보니 여러 요청을 동시에 처리하는 문제까지는 고민할 일이 없었습니다. 그러다 밋업 세션을 듣고, FriendliAI와 LG AI Research에서 추론 엔진을 개발하시는 분들과 이야기를 나누면서 추론 엔진에 관심이 생겼습니다.
그래서 이번 글에서는 어떤 추론 최적화 기법들이 쓰이는지 vLLM을 중심으로 간단히 알아보려고 합니다!
1. LLM 추론이 일반 API 서빙과 다른 점
LLM 서빙에서 까다로운 건 연산량보다 메모리와 스케줄링입니다. 왜 그런지 요청 하나가 처리되는 과정부터 살펴보겠습니다.
LLM에 요청을 보내면 입력 텍스트는 먼저 토큰 단위로 쪼개집니다(토큰화). 모델은 이 토큰들을 보고 다음 토큰 하나를 예측하고, 예측한 토큰을 입력 뒤에 붙여 다시 다음 토큰을 예측합니다. 종료 토큰이 나오거나 길이 제한에 닿을 때까지 이걸 반복한 뒤, 토큰을 다시 텍스트로 바꿔(디토큰화) 응답합니다.
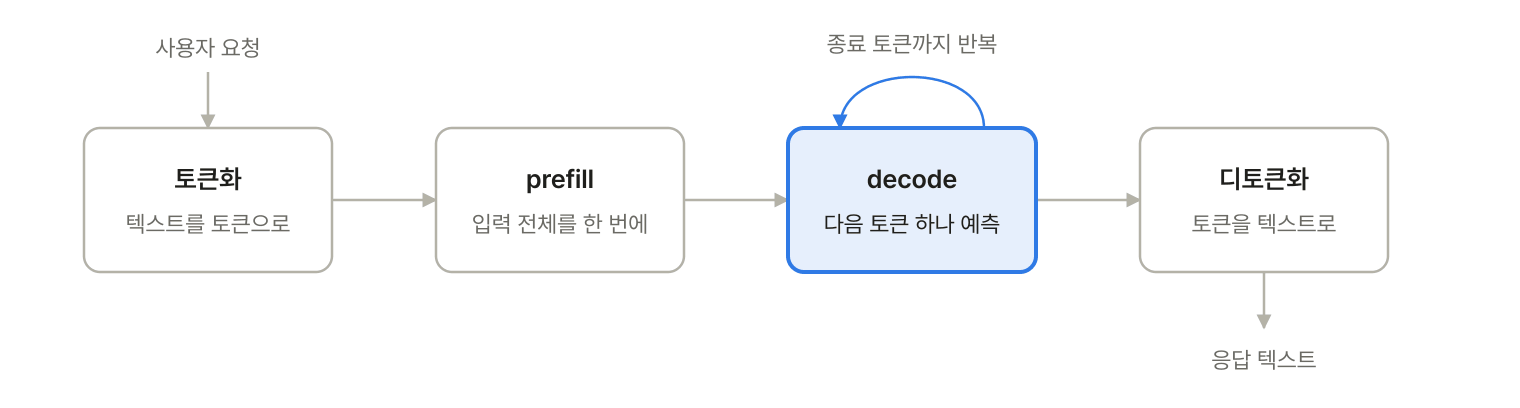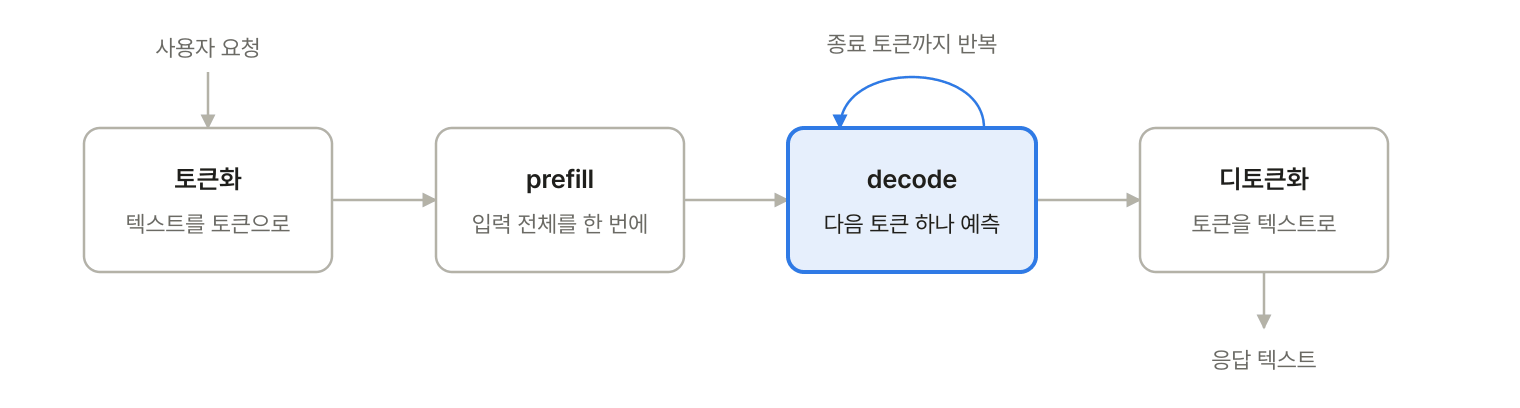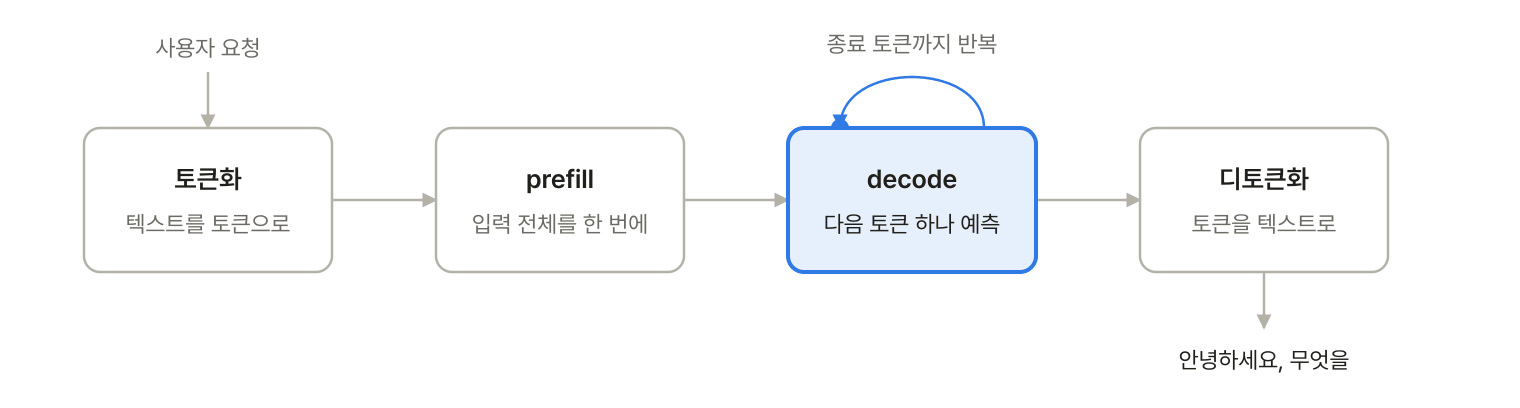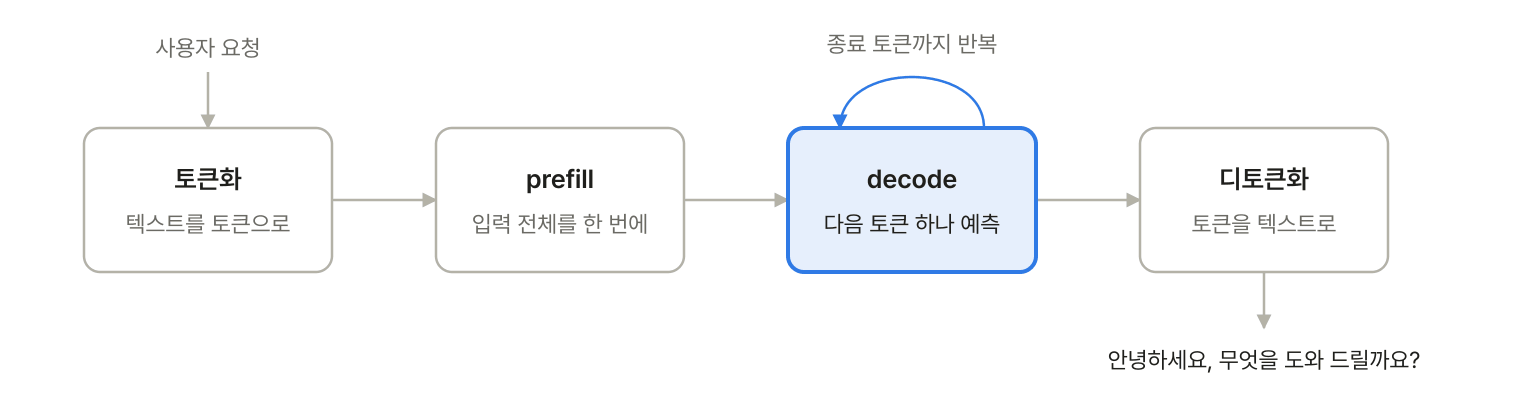
이 과정은 두 단계로 나눌 수 있습니다. 입력 프롬프트 전체를 한 번에 처리하는 prefill, 그리고 출력 토큰을 하나씩 만들어내는 decode입니다. 까다로운 쪽은 decode입니다. 토큰 하나를 만들 때마다 모델 가중치 전체를 GPU 메모리에서 읽어와야 하는데, GPU의 연산 속도에 비해 메모리를 읽는 속도가 느려서 계산보다 읽기를 기다리는 시간이 더 깁니다. 이런 상태를 memory-bound라고 합니다. 반대로 말하면 한 번 읽은 가중치로 여러 요청의 토큰을 함께 만들수록 GPU를 효율적으로 쓸 수 있다는 뜻이고, 이게 섹션 2에서 다룰 배치의 출발점입니다.
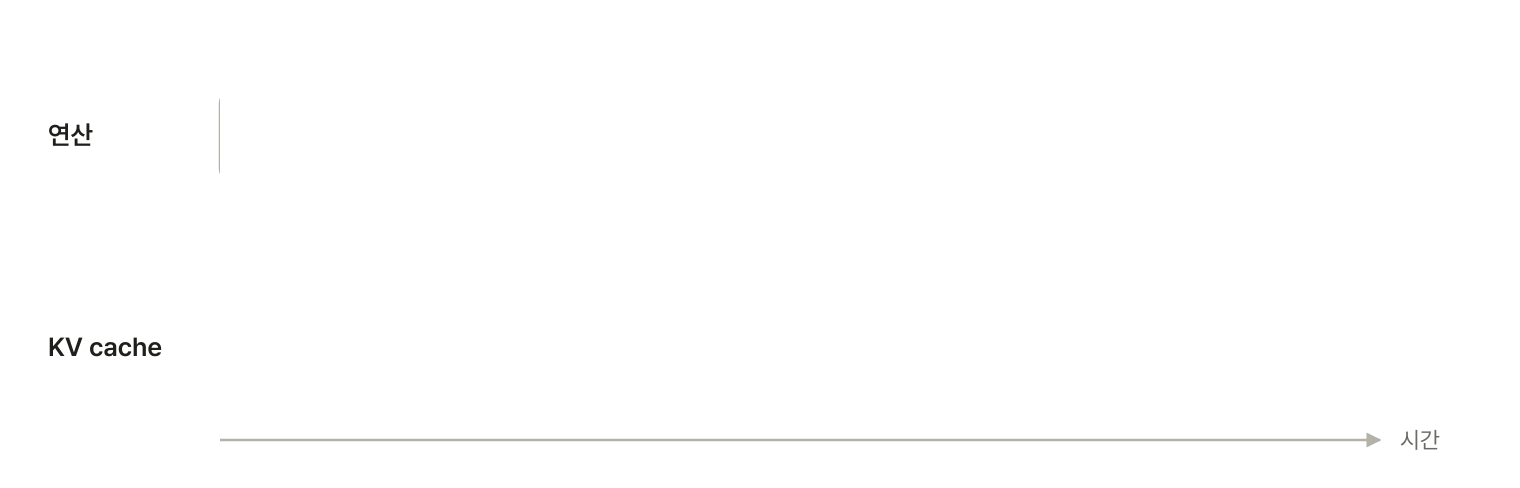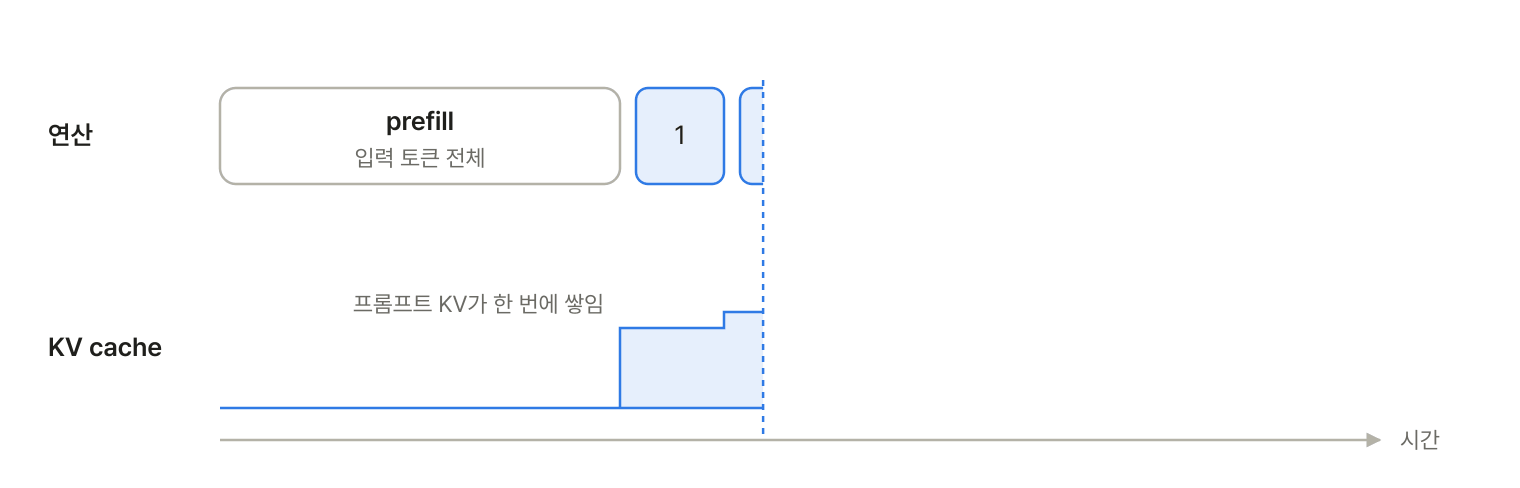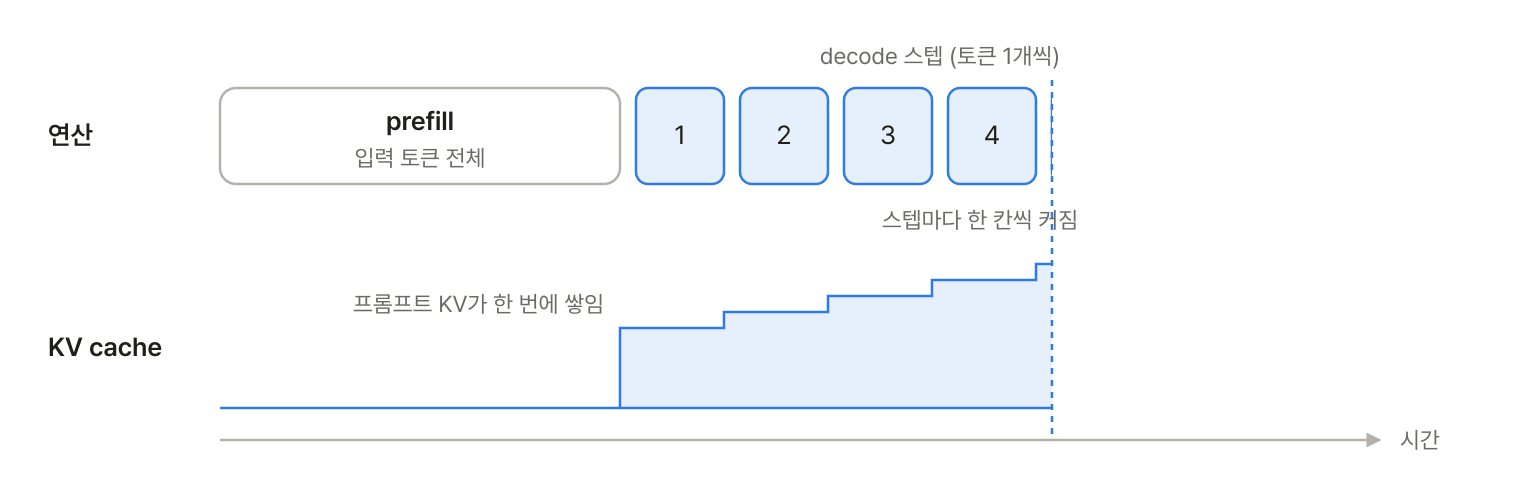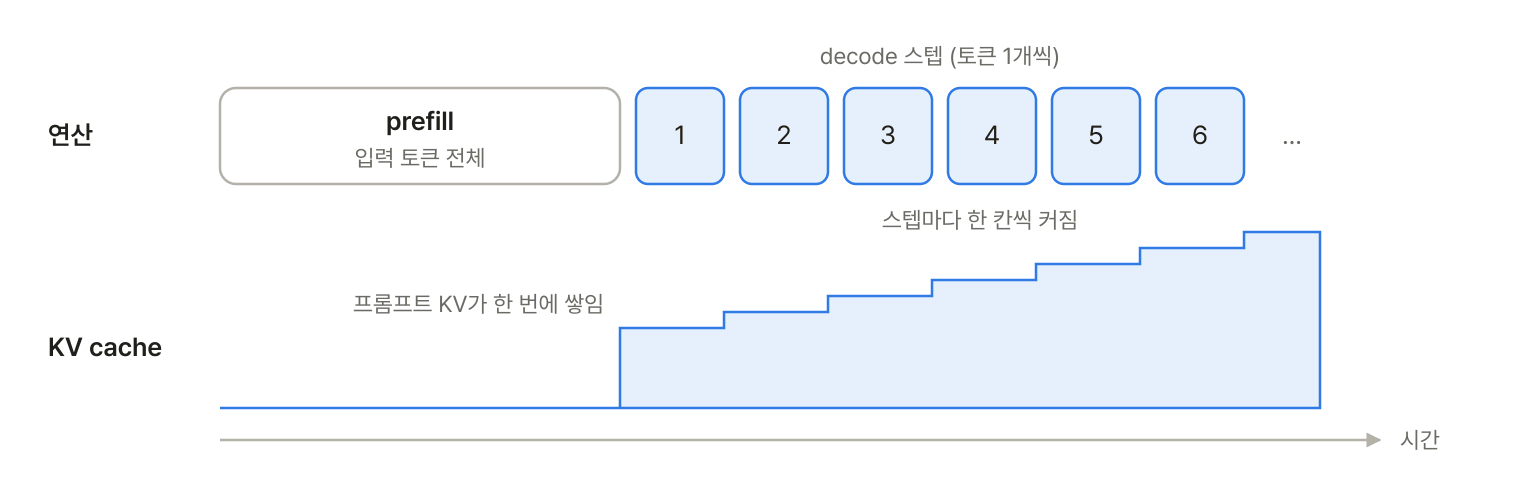
decode에는 KV cache도 필요합니다. KV cache는 앞서 처리한 토큰들의 attention key와 value를 저장해두는 공간입니다. 이게 없으면 토큰 하나를 만들 때마다 앞의 토큰 전체를 다시 계산해야 하죠. 대신 KV cache는 요청마다 따로 있어야 하고, 생성이 끝날 때까지 토큰 수만큼 계속 커집니다.
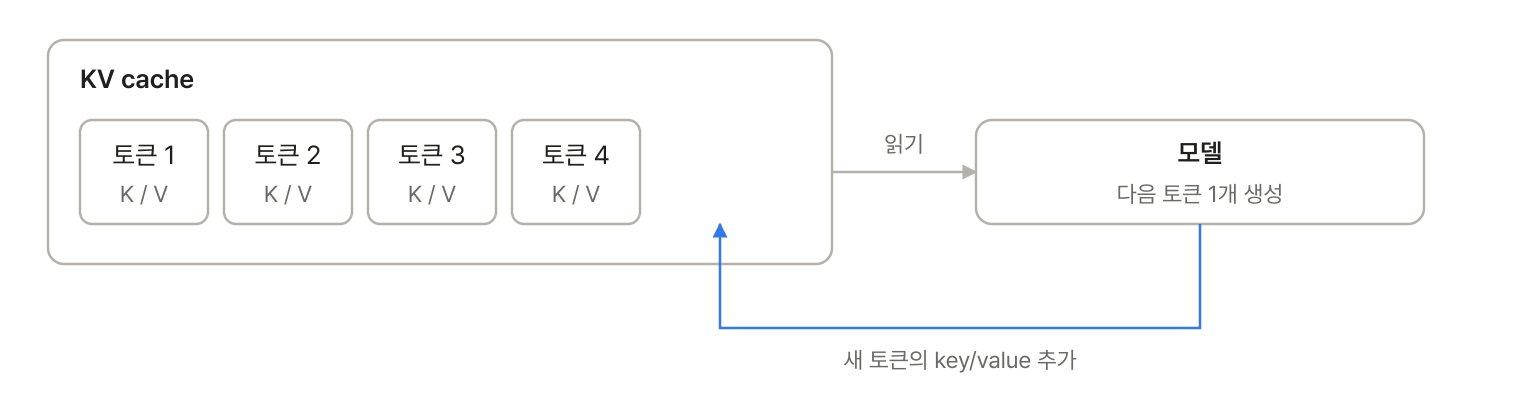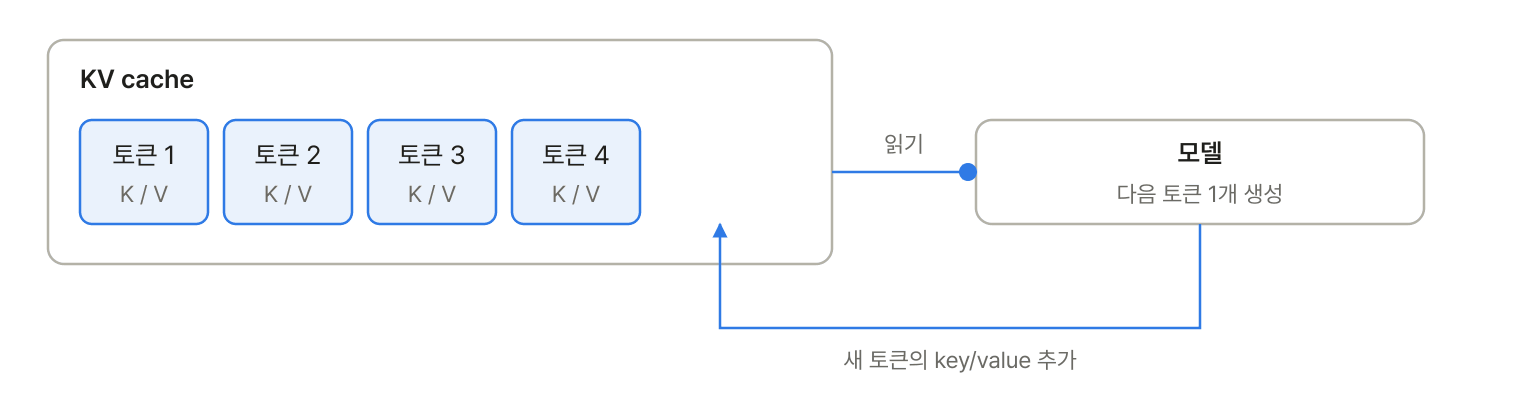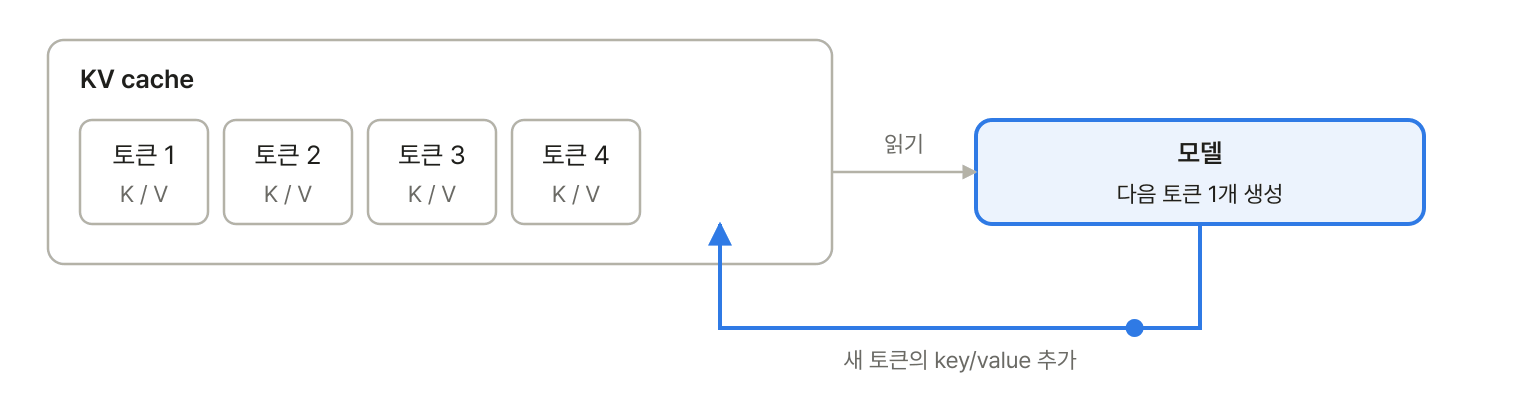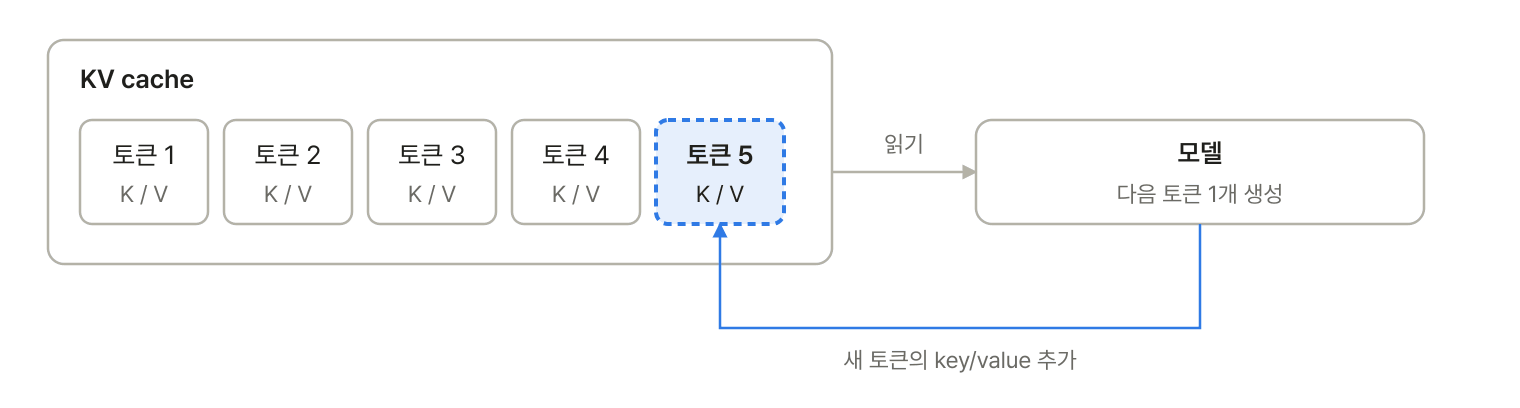
일반적인 API 서버라면 요청 하나가 얼마나 걸리고 메모리를 얼마나 쓸지 대략 예상할 수 있습니다. LLM은 응답이 짧게 끝날지 길게 이어질지 미리 알 수 없습니다. 그래서 요청마다 메모리를 얼마나 잡아둘지, 언제 자리가 비어 다음 요청을 받을 수 있을지 예측하기 어렵습니다. 이후 섹션에서 다룰 기법은 모두 이 문제를 푸는 방법입니다.
2. continuous batching: 배치를 스텝 단위로
섹션 1에서 한 번 읽은 가중치로 여러 요청의 토큰을 함께 만들수록 GPU를 효율적으로 쓸 수 있다고 했습니다. 그래서 서빙 엔진은 요청 여러 개를 배치로 묶어 처리합니다. 문제는 어떻게 묶느냐입니다.
기존 서빙 시스템은 request-level batching을 썼습니다. 요청 여러 개를 배치 하나로 묶고, 배치 안의 요청이 전부 끝나야 다음 배치를 시작하는 방식입니다. 짧은 응답이 먼저 끝나도 그 자리는 배치가 끝날 때까지 비어 있고, 그사이 새로 들어온 요청은 현재 배치가 끝나기를 기다려야 합니다. 섹션 1에서 본 것처럼 출력 길이가 요청마다 달라서 이런 빈자리는 자주 생깁니다.
continuous batching은 배치를 짜는 단위를 요청이 아니라 decode 스텝으로 바꿉니다. 매 스텝마다 끝난 요청은 배치에서 빼고, 대기 중인 요청을 그 자리에 넣습니다. 빈자리가 생기는 즉시 채워지니 GPU가 쉬는 시간이 줄고, 새 요청도 스텝 하나만 기다리면 처리에 들어갈 수 있죠. vLLM을 비롯한 대부분의 서빙 엔진이 이 방식으로 배치를 짭니다.
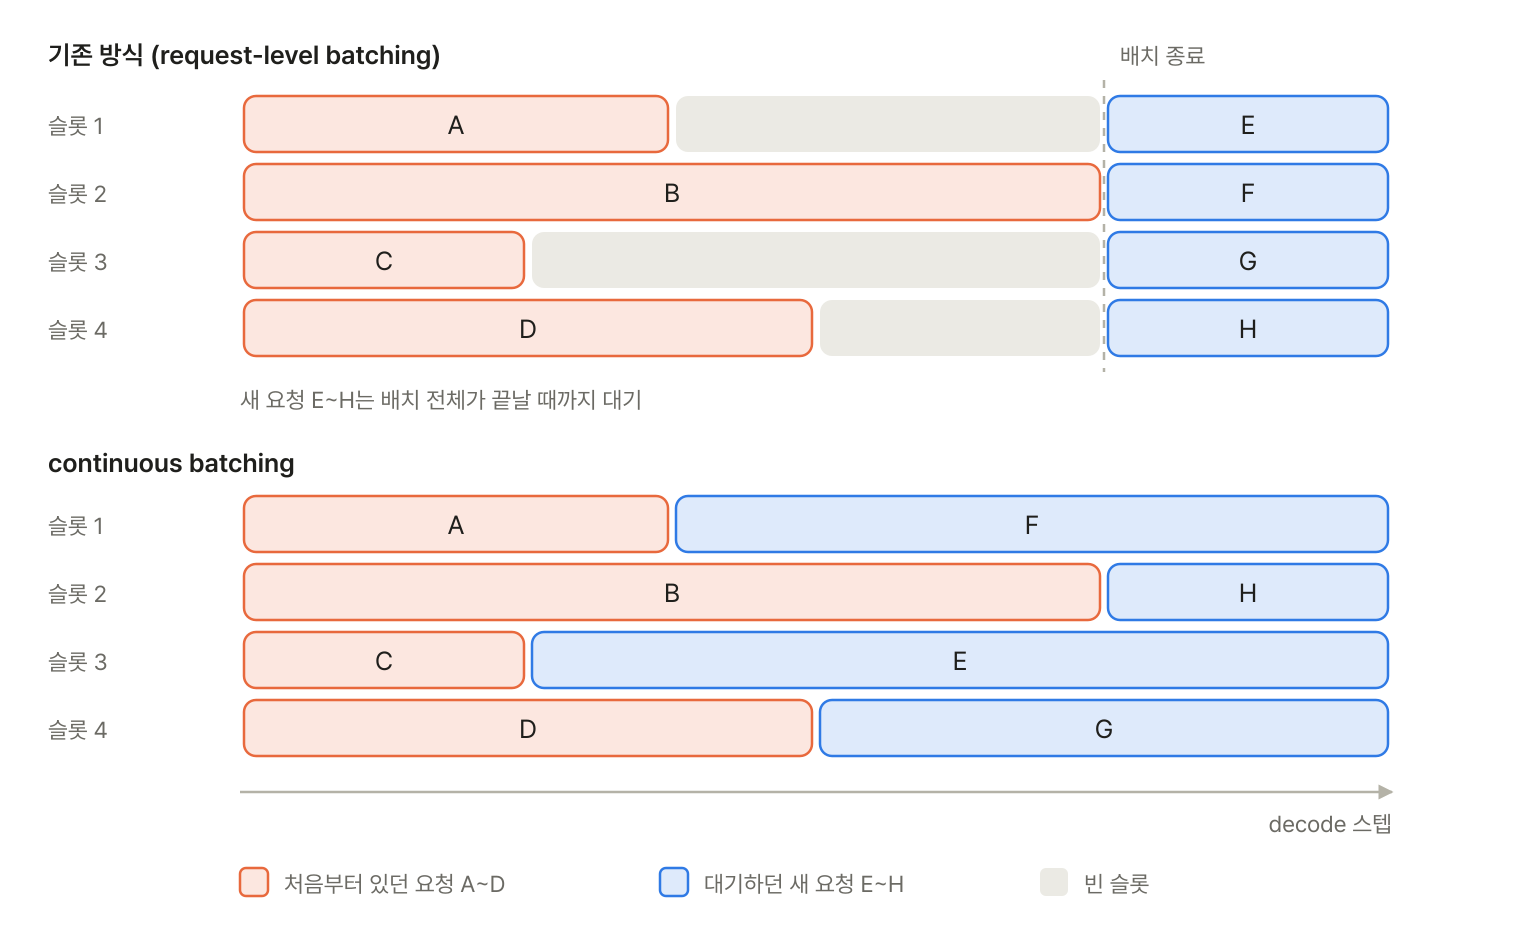
이 방식은 OSDI 2022에 발표된 Orca 논문에서 iteration-level scheduling이라는 이름으로 처음 제안됐습니다. 저자 목록에는 밋업 연사였던 전병곤 대표가 FriendliAI와 서울대 소속으로 올라 있습니다.
3. vLLM: KV cache를 블록 단위로 관리하기
continuous batching으로 빈자리를 바로 채울 수 있게 됐지만, 배치에 요청을 한 번에 몇 개까지 넣을 수 있는지는 결국 GPU 메모리가 정합니다. 섹션 1에서 봤듯 요청마다 KV cache가 필요하고, 이 KV cache를 어떻게 관리하느냐에 따라 동시에 올릴 수 있는 요청 수가 달라집니다.
기존 시스템은 요청마다 최대 출력 길이만큼 연속된 메모리를 미리 예약했습니다. 출력 길이를 모르니 최댓값 기준으로 잡을 수밖에 없었죠. 그 결과 실제로는 쓰지 않는 예약 공간이 생깁니다. 요청마다 예약 크기도 달라서, 할당과 해제가 반복되면 사이사이에 쓰기 어려운 작은 빈 공간이 남습니다(단편화).
SOSP 2023에 발표된 vLLM 논문은 이 문제를 PagedAttention으로 풉니다. 운영체제의 가상 메모리 페이징에서 착안한 방식으로, KV cache를 고정 크기 블록으로 쪼개고 필요할 때만 할당합니다.
- KV cache를 고정 개수의 토큰을 담는 블록으로 나누고, 블록 테이블이 요청의 논리 블록과 GPU의 물리 블록을 매핑합니다.
- 물리 블록은 연속일 필요가 없습니다. 토큰이 현재 블록을 다 채우면 그때 새 블록을 하나 할당합니다. 낭비는 요청마다 마지막 블록의 남은 칸 정도로 줄어듭니다.
- 같은 프롬프트를 공유하는 요청(병렬 샘플링 등)은 프롬프트 부분의 물리 블록을 함께 가리킵니다. 한쪽이 그 블록을 수정해야 할 때만 복사합니다(copy-on-write).
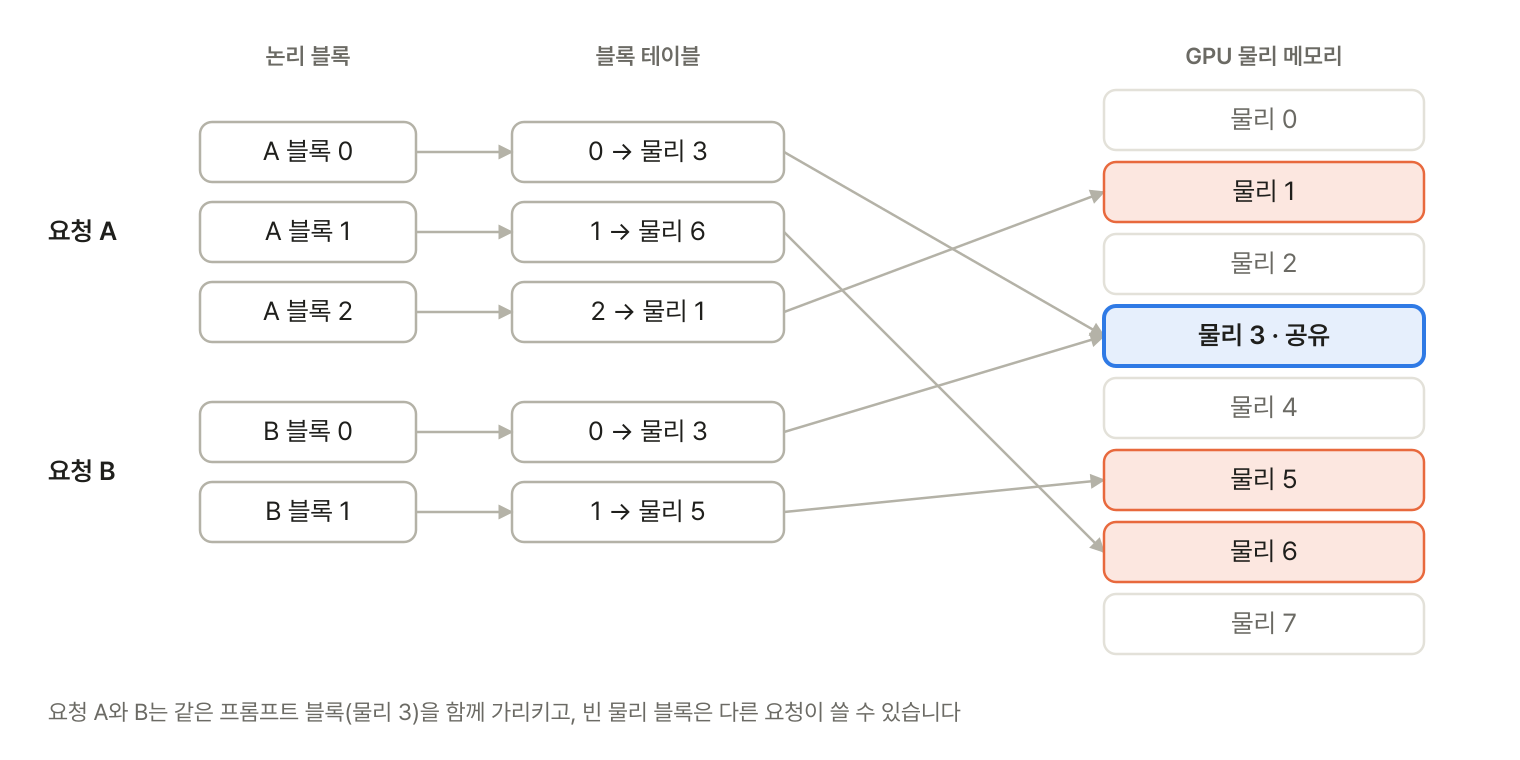
메모리 낭비가 줄어든 만큼 같은 GPU에 더 많은 요청을 올릴 수 있고, 섹션 2의 continuous batching은 그 요청들로 매 스텝 배치를 채웁니다. 두 기법이 함께 작동하는 셈입니다.
4. 이 밖의 기법들
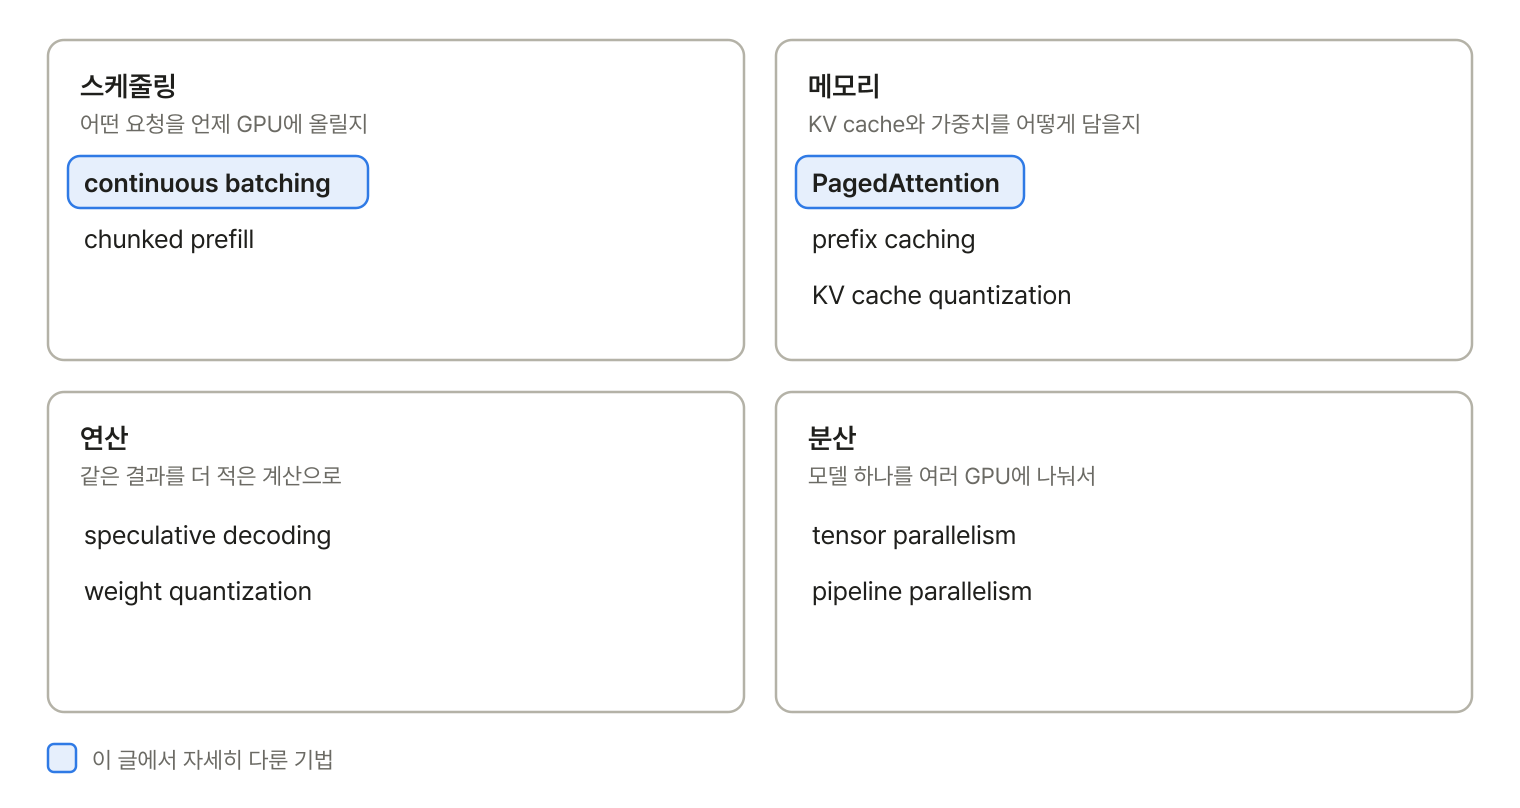
섹션 2와 3에서 본 continuous batching과 PagedAttention은 각각 스케줄링과 메모리 쪽 기법입니다. 이 밖에도 연산, 분산 계층마다 최적화 지점이 있어서 분야 자체가 꽤 넓습니다. 자주 언급되는 기법을 짧게 정리해보겠습니다.
- prefix caching: 시스템 프롬프트처럼 여러 요청에 반복되는 앞부분의 KV cache를 요청 간에 재사용합니다. 같은 prefill을 매번 다시 계산하지 않아도 됩니다.
- chunked prefill: 긴 prefill을 잘게 나눠 decode 스텝 사이에 섞습니다. 긴 프롬프트가 들어와도 진행 중인 다른 요청의 응답이 끊기지 않습니다.
- speculative decoding: 작은 모델이 토큰 여러 개를 먼저 제안하면 큰 모델이 한 번에 검증합니다. 맞힌 만큼 큰 모델의 decode 횟수가 줄어듭니다.
- quantization: 가중치와 KV cache의 정밀도를 낮춰 메모리와 대역폭을 아낍니다.
- tensor / pipeline parallelism: GPU 하나에 들어가지 않는 모델을 여러 GPU에 나눠 올립니다. tensor parallelism은 레이어 안의 연산을, pipeline parallelism은 레이어 묶음을 나눕니다.
마치며
이번 글에서는 LLM 서빙이 왜 연산보다 메모리와 스케줄링의 문제인지 살펴보고, 이를 푸는 continuous batching과 PagedAttention을 vLLM을 중심으로 정리했습니다.
이번 밋업에서 모델을 서비스로 제공하는 쪽이 무엇을 신경 쓰는지 듣고 나서야, 그동안 제가 AI 모델을 쓰는 사람 입장에서만 봐 왔다는 걸 알게 됐습니다. 답이 한 토큰씩 흘러나오는 화면 뒤에서는 요청을 배치로 묶고 KV cache를 나눠 담는 일이 계속 일어나고 있었고, 이걸 다루는 추론 엔진도 생각보다 훨씬 재미있는 분야였습니다.
앞으로는 새 모델이 나오면 벤치마크 점수와 함께, 그 모델을 어떻게 서빙하는지도 관심을 갖고 지켜보려고 합니다.
출처
Comments
Join the discussionNo comments yet. Be the first to comment.

